Vision-as-a-Tool: Visual Harness for Multimodal Agentic Coding
- 1
 Peking University
- 2
 Microsoft
- 3
- 4
What if a coding agent could use vision as a tool—just like Bash?
Key Takeaways
The VaaT Paradigm, Instantiated in VHarness
Vision-as-a-Tool (VaaT) decouples visual perception from code generation; VHarness instantiates this paradigm by exposing an external MLLM through five Bash-like atomic visual actions.
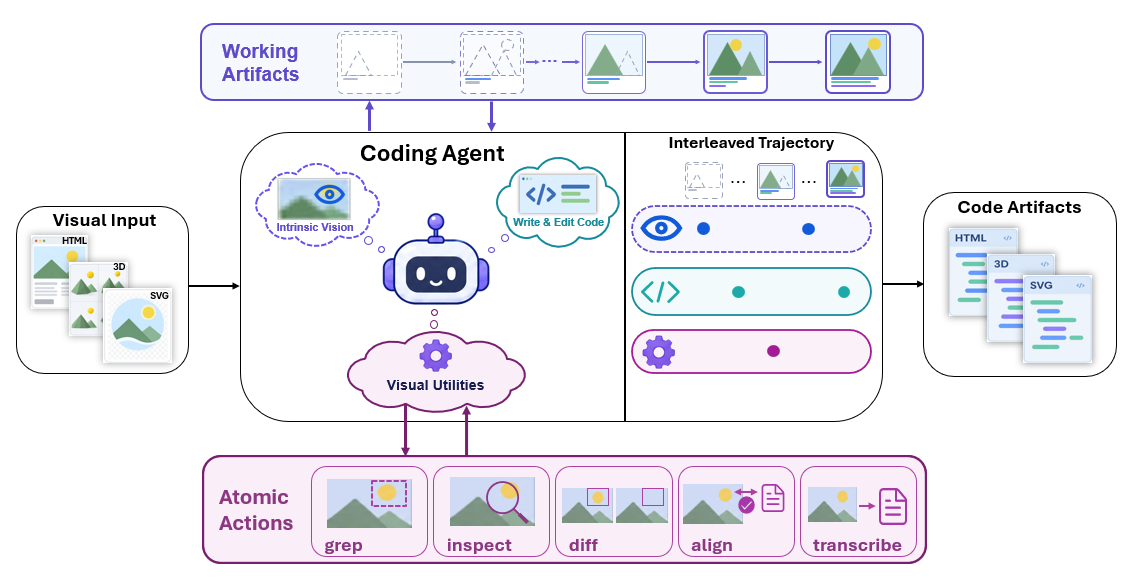
transcribeHolistic layout and structure draftgrepVisual element localizationinspectFine-grained detail observationalignVisual assertion checkingdiffTarget vs. render discrepancy detection
Experimental Results
01Main comparison
results.csvΔ, darker means larger gain
Video Showcase
Each case pairs the target ground-truth image with the rendered code artifact throughout the refinement process.Click any case to watch it in full.
Video Comparison
Each case pairs the target ground-truth image with baseline outputs and VHarness outputs.Click any case to watch it in full.